n8n vs Make vs Zapier vs Power Automate: qual usar na empresa
Categoria: Automação e IA
Cookies e medição
Guardamos só o necessário para o site funcionar e medimos visitasMedimos visitas com o Umami, no nosso próprio servidor, sem cookies e sem guardar o seu IP. A medição fica ativa por legítimo interesse, e você pode desligá-la. Detalhes na Política de Cookies.
O que é RAG, como montar um assistente que responde com os documentos da empresa, quanto custa por pergunta, cuidados com permissão e LGPD e quando não usar.
RAG é a técnica que permite a um assistente responder com base nos documentos da sua empresa (manuais, políticas, contratos-modelo, perguntas frequentes) em vez de responder só com o que o modelo aprendeu na internet. O sistema busca os trechos relevantes, entrega ao modelo de linguagem e pede uma resposta que cite a fonte. Com os preços de outubro de 2026, o custo por pergunta fica em frações de centavo a alguns centavos de real; o trabalho está em preparar a base e medir a qualidade.
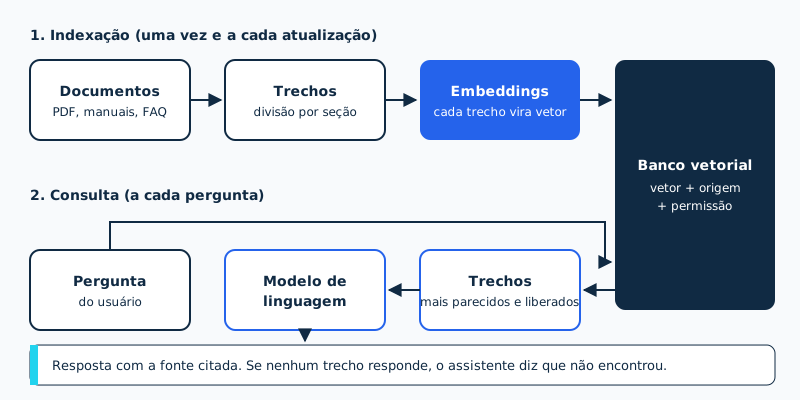
RAG (Retrieval-Augmented Generation, geração aumentada por recuperação) junta uma busca nos seus documentos com um modelo de linguagem. A cada pergunta, o sistema encontra os trechos mais relevantes e pede ao modelo que responda usando apenas esses trechos. O modelo não é treinado de novo, e atualizar o conhecimento é atualizar os documentos.
Três consequências práticas dessa arquitetura:
Casos de uso típicos em pequenas e médias empresas: atendimento interno de RH (férias, benefícios, políticas), suporte técnico de primeiro nível com base em manuais, consulta de procedimentos operacionais e respostas a clientes sobre produtos, prazos e condições.
Um assistente com RAG tem duas etapas. Na indexação, os documentos são divididos em trechos, cada trecho vira um vetor numérico (embedding) e vai para um banco vetorial. Na consulta, a pergunta também vira vetor, o banco devolve os trechos mais parecidos, e o modelo de linguagem escreve a resposta com eles.
| Etapa | O que acontece | Decisões que pesam na qualidade |
|---|---|---|
| Coleta | Documentos saem das pastas, do drive ou do sistema de origem | Quais fontes entram; quem é o dono de cada documento |
| Extração | O texto é extraído de PDF, DOCX, planilhas e páginas | PDF escaneado precisa de OCR; tabelas precisam virar texto legível |
| Divisão em trechos | Cada documento vira trechos de algumas centenas de tokens | Dividir por seção e título, não por número fixo de caracteres |
| Embeddings | Cada trecho vira um vetor que representa o sentido do texto | Modelo com bom desempenho em português |
| Banco vetorial | Vetores ficam guardados com a origem, a data e a permissão | Pode ser o próprio PostgreSQL com a extensão pgvector |
| Busca | A pergunta vira vetor, e o banco devolve os trechos mais próximos | Filtro de permissão; busca por palavra-chave junto (híbrida); reordenação (rerank) |
| Geração | O modelo responde só com os trechos recebidos e cita a fonte | Instrução para dizer “não encontrei” quando a base não tem a resposta |
O ponto que mais diferencia um assistente útil de um frustrante não é o modelo de linguagem, e sim a preparação dos documentos: extração limpa, divisão por seção e remoção de versões antigas e duplicadas.
São três formas de dar conhecimento da empresa a um modelo. RAG busca trechos a cada pergunta e serve para bases grandes e que mudam. Fine-tuning ajusta o modelo e serve para estilo e formato, não para fatos. Contexto longo envia os documentos inteiros a cada pergunta e serve quando a base é pequena.
| Critério | RAG | Fine-tuning | Contexto longo com cache |
|---|---|---|---|
| Tamanho da base | De dezenas a milhares de documentos | Não se aplica a fatos | Até algumas dezenas de páginas |
| Atualizar um documento | Reindexar o documento | Treinar de novo | Trocar o texto enviado |
| Cita a fonte | Sim | Não | Sim, se instruído |
| Controle de acesso por usuário | Na busca, por trecho | Não | Montando um contexto por perfil |
| Custo por pergunta | Baixo (só os trechos relevantes) | Baixo, mas com custo de treino | Baixo com cache; alto sem cache |
| Complexidade | Média: indexação, banco e busca | Alta: dados de treino e avaliação | Baixa |
O contexto longo merece atenção porque costuma ser esquecido. Com cache de prompt, um conjunto de 50 páginas (cerca de 25.000 tokens) lido do cache custa cerca de US$ 0,00025 por pergunta no Claude Haiku 5.5 (preço válido para prompts de até 100 mil tokens), pela tabela da Anthropic de outubro de 2026, sem contar a gravação do cache, que é mais cara. Se a base é pequena e muda pouco, vale testar esse caminho antes de montar um RAG.
O custo variável de um assistente com RAG é baixo: indexar alguns milhões de tokens de documentos custa centavos de dólar, e cada pergunta custa de frações de centavo a alguns centavos de real, conforme o modelo. O que pesa no orçamento é o servidor, a implantação e a manutenção da base de documentos.
Premissas (outubro de 2026):
Indexação (paga uma vez e de novo só para os documentos que mudarem):
| Modelo de embeddings | Preço por milhão de tokens | Indexar 5 milhões de tokens |
|---|---|---|
| OpenAI text-embedding-3-small | US$ 0,02 | US$ 0,10 |
| OpenAI text-embedding-3-large | US$ 0,13 | US$ 0,65 |
| Voyage AI voyage-4-lite | US$ 0,02 | US$ 0,10 (dentro da franquia grátis de 200 milhões) |
| Voyage AI voyage-4 | US$ 0,06 | US$ 0,30 (dentro da franquia grátis de 200 milhões) |
Fontes: preços da OpenAI e preços da Voyage AI, consultados em 27/10/2026. O embedding de cada pergunta (algumas dezenas de tokens) tem custo desprezível.
Geração da resposta:
| Modelo de linguagem | Entrada / saída por milhão de tokens | Custo por pergunta | 3.000 perguntas por mês |
|---|---|---|---|
| Claude Haiku 5.5 (menor; preço para prompts de até 100 mil tokens) | US$ 0,10 / US$ 0,50 | US$ 0,0006 ≈ R$ 0,003 | ≈ R$ 9,18 |
| Claude Sonnet 5.5 (intermediário) | US$ 2 / US$ 10 | US$ 0,012 ≈ R$ 0,06 | ≈ R$ 183,60 |
Usamos a Anthropic como exemplo porque publica a tabela completa; para outros provedores, confira a tabela de cada um. Com o banco vetorial no próprio PostgreSQL, o servidor costuma ser o mesmo da automação (premissa: de R$ 60 a R$ 300 por mês, conforme a disponibilidade exigida). Se o assistente responde pelo WhatsApp, somam-se as tarifas da Meta, detalhadas em quanto custa um agente de IA para WhatsApp.
Um assistente com RAG só é seguro se respeitar as mesmas permissões dos documentos de origem e se a empresa souber para onde cada trecho viaja. Os trechos usados na resposta vão para o provedor do modelo, e os documentos inteiros passam pelo provedor de embeddings na indexação.
Cuidados que entram no projeto desde o início:
A adequação à LGPD depende do conjunto: base legal, contratos com operadores, controle de acesso, registro e retenção. Hospedar o banco vetorial no próprio servidor ajuda no controle, mas não resolve sozinho.
A qualidade de um assistente com RAG se mede antes de liberar para os usuários, com um conjunto de perguntas reais e respostas esperadas. Sem esse conjunto, cada ajuste vira opinião, e um erro de extração ou de divisão de trechos só aparece quando alguém reclama.
Um roteiro de avaliação que funciona para começar:
RAG não é a ferramenta certa quando a resposta está num sistema estruturado, quando a base cabe inteira no contexto do modelo ou quando a pergunta exige cálculo exato. Nesses casos, consulta direta ao sistema, contexto longo ou uma regra programada respondem melhor e com menos peças para manter.
| Situação | Melhor caminho | Por quê |
|---|---|---|
| “Qual o status do pedido 4521?” | Consulta à API do ERP ou do e-commerce | O dado está numa tabela e muda a cada minuto |
| “Quanto vendemos em setembro?” | Relatório ou consulta ao banco de dados | Exige soma exata, não texto parecido |
| Base com poucas páginas, que muda pouco | Contexto longo com cache | Menos peças: sem indexação e sem banco vetorial |
| Regra fixa (prazo, tabela de frete) | Regra programada no fluxo | Resposta determinística e testável |
| Documentos em constante mudança, em volume | RAG | É o caso para o qual a técnica existe |
Na prática, muitos assistentes combinam os caminhos: RAG para políticas e manuais, consulta à API para pedidos e estoque, e regras fixas para prazos. Um orquestrador como o n8n decide qual caminho cada pergunta segue; veja o comparativo n8n vs Make vs Zapier vs Power Automate.
A SDI começa por um recorte: uma área, um conjunto de documentos e um conjunto de perguntas de teste com critério de aceite. A base é preparada, o assistente é medido contra esse conjunto e só depois é liberado. Código, workflows, banco e credenciais ficam em nome da empresa.
Na automação com IA, automações com IA têm referência a partir de R$ 5.000, e a automação piloto, com um processo e até três integrações, parte de R$ 3.000; a manutenção parte de R$ 300 por mês. Valores de referência: cada atendimento é dimensionado após levantamento do escopo. Os custos de terceiros (modelo de linguagem, embeddings e servidor) são cobrados à parte, em nome do cliente.
RAG (Retrieval-Augmented Generation, ou geração aumentada por recuperação) é uma técnica em que o sistema primeiro busca os trechos relevantes nos documentos da empresa e depois pede ao modelo de linguagem que responda usando só esses trechos, citando a fonte. O modelo não é treinado de novo com os seus dados.
O custo variável é baixo. Com as tabelas públicas de outubro de 2026 e as premissas do artigo, 3.000 perguntas por mês custam de cerca de R$ 9 a R$ 184 em modelo de linguagem, e indexar 5 milhões de tokens de documentos custa centavos de dólar. O peso maior está no servidor, na implantação e na manutenção da base.
Para responder com base em documentos que mudam, RAG costuma ser a escolha: atualizar a base é reindexar o documento, e a resposta pode citar a fonte. Fine-tuning ajusta estilo e formato de resposta, mas não é uma boa forma de manter fatos atualizados.
Os trechos usados em cada resposta são enviados ao provedor do modelo e, na indexação, ao provedor de embeddings. Por isso é preciso conferir a política de uso de dados e o contrato de cada provedor, classificar o que pode ser enviado e, quando necessário, usar modelos executados no próprio servidor.
Pode, como qualquer sistema com modelo de linguagem. O risco diminui quando o assistente é instruído a responder só com os trechos recuperados, cita a fonte e diz que não encontrou quando a base não tem a resposta, e quando a qualidade é medida com um conjunto de perguntas reais antes de entrar em uso.
Os artigos do blog são escritos pela equipe da SDI — Serviços Digitais Integrados e assinados pela empresa. Somos três sócios técnicos que projetam, documentam e mantêm redes, servidores, integrações e automações com IA para pequenas e médias empresas. Quando um sócio revisa a parte técnica, o nome dele aparece no topo do artigo.
Conheça a equipeUm e-mail quando sair um artigo novo ou uma atualização de preços. Descadastro em um clique.
Fluxos n8n e agentes de IA conectados aos seus sistemas: atendimento no WhatsApp, extração de documentos, relatórios automáticos e RAG, rodando no seu servidor.
Respondemos em até 1 dia útil, de segunda a sexta, das 9h às 17h.